

Dwie karty graficzne do AI: PCIe x8 vs x16. Porównanie wydajności oraz kosztów
Rosnące wymagania modeli językowych, systemów generowania obrazów i wideo oraz coraz większa popularność lokalnych środowisk AI sprawiają, że profesjonaliści i firmy coraz częściej stają przed pytaniem, czy wystarczy pojedyncza karta graficzna, czy też warto od razu inwestować w konfigurację wyposażoną w dwie karty graficzne.
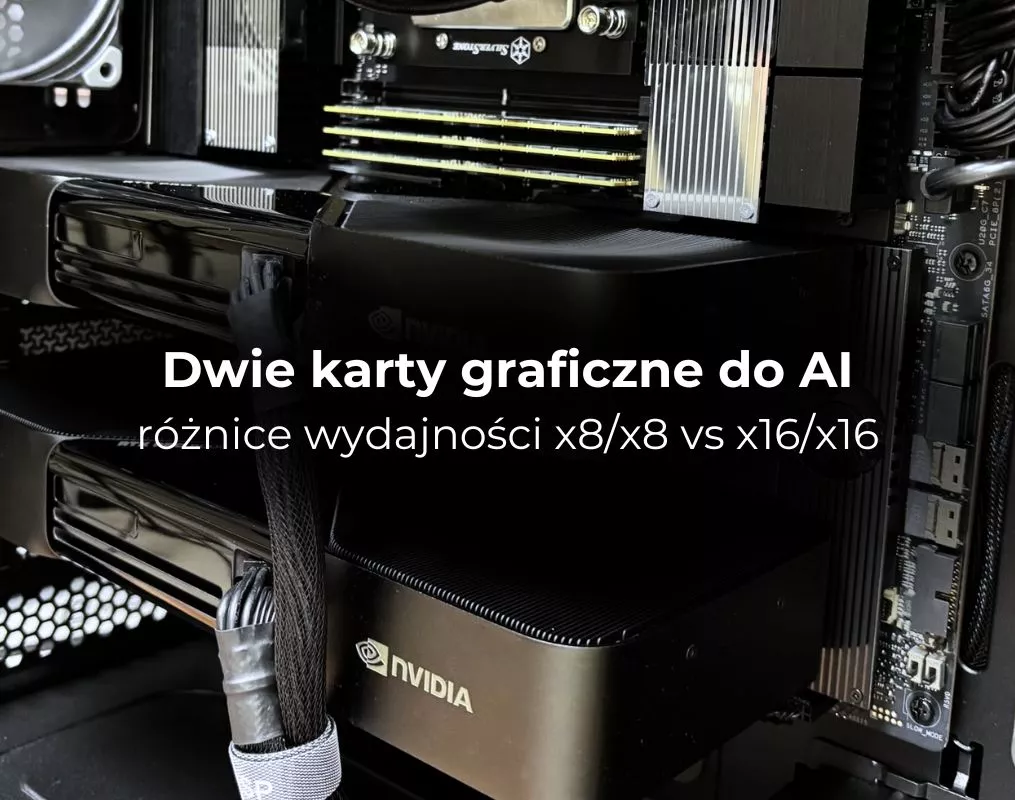
W przypadku nowoczesnych akceleratorów, takich jak NVIDIA RTX 6000 Pro Blackwell 96 GB, decyzja nie sprowadza się wyłącznie do ceny samych kart. Równie ważna jest platforma sprzętowa, liczba dostępnych linii PCI Express, ilość pamięci RAM, możliwości rozbudowy oraz charakter wykonywanych obliczeń. W praktyce najczęściej rozważane są dwa scenariusze. Pierwszy zakłada wykorzystanie platformy AM5 z procesorem AMD Ryzen 9 i dwiema kartami RTX 6000 Pro Blackwell 96 GB pracującymi w trybie PCIe 5.0 x8/x8. Drugie rozwiązanie opiera się na platformie AMD Ryzen Threadripper lub Threadripper PRO, która zapewnia pełną przepustowość PCIe x16/x16 dla obu kart, większą liczbę linii PCIe oraz możliwość dalszej rozbudowy.
Choć intuicyjnie można założyć, że Threadripper będzie zawsze zdecydowanie szybszy, rzeczywistość okazuje się znacznie bardziej złożona. W wielu zastosowaniach różnice pomiędzy obiema platformami są niewielkie, a w niektórych scenariuszach tańsza platforma AM5 zapewnia niemal identyczną wydajność.
Czy jedna karta RTX 6000 Pro Blackwell 96 GB wystarczy?
RTX 6000 Pro Blackwell wyposażona w 96 GB pamięci VRAM należy do najwydajniejszych profesjonalnych kart graficznych dostępnych na rynku. Pojedynczy akcelerator oferuje ogromną moc obliczeniową, która dla większości zastosowań związanych z inferencją modeli AI jest w pełni wystarczająca. Jedna karta pozwala na uruchamianie bardzo dużych modeli językowych, wykonywanie fine-tuningu przy użyciu LoRA, generowanie obrazów i materiałów wideo, pracę z modelami multimodalnymi, analizę danych oraz obsługę środowisk produkcyjnych. Dzięki 96 GB VRAM możliwe staje się uruchamianie modeli, które jeszcze kilka lat temu wymagały wieloserwerowych klastrów GPU.
Dla wielu przedsiębiorstw pojedynczy RTX 6000 Pro Blackwell jest najbardziej opłacalnym rozwiązaniem. Taka konfiguracja jest prostsza, zużywa mniej energii, generuje mniej ciepła i nie wymaga inwestowania w bardziej rozbudowane platformy HEDT. Dopiero w sytuacji, gdy ilość pamięci VRAM lub moc pojedynczego GPU przestają wystarczać, pojawia się sens zastosowania drugiej karty.
Kiedy warto zastosować dwie karty graficzne (multi GPU)?
Dodanie drugiej karty graficznej nie zawsze oznacza dwukrotny wzrost wydajności. Wszystko zależy od rodzaju obciążenia. Niektóre zadania niemal idealnie skalują się wraz z liczbą GPU, podczas gdy inne wykorzystują dodatkowy akcelerator jedynie częściowo. Największe korzyści z konfiguracji dwuprocesorowej pojawiają się podczas trenowania modeli AI, fine-tuningu dużych modeli językowych, generowania wideo oraz pracy z ogromnymi zbiorami danych. Dwa RTX 6000 Pro Blackwell oznaczają w praktyce dostęp do 192 GB VRAM i ogromnej mocy obliczeniowej, co umożliwia pracę z modelami klasy 70B, 120B i większymi. Drugie GPU jest również bardzo przydatne w środowiskach wielozadaniowych. Jedna karta może obsługiwać generowanie odpowiedzi przez model językowy, podczas gdy druga zajmuje się analizą dokumentów, przetwarzaniem obrazów lub obsługą kolejnych użytkowników. W środowiskach serwerowych i produkcyjnych takie podejście znacząco zwiększa przepustowość systemu.
Platforma AM5 i dwie karty graficzne w trybie PCIe x8/x8
Platforma AM5 z procesorami Ryzen 9 oferuje ograniczoną liczbę linii PCI Express wychodzących bezpośrednio z procesora. W praktyce oznacza to, że przy zastosowaniu dwóch kart graficznych obie pracują najczęściej w konfiguracji PCIe 5.0 x8/x8. Na pierwszy rzut oka może wydawać się to poważnym ograniczeniem, jednak przepustowość magistrali PCIe 5.0 jest na tyle duża, że dla większości zastosowań AI różnice są bardzo niewielkie. PCIe 5.0 x8 oferuje przepustowość zbliżoną do PCIe 4.0 x16, które jeszcze niedawno było standardem dla najwydajniejszych serwerów GPU. W przypadku inferencji modeli językowych większość danych znajduje się w pamięci VRAM i komunikacja z magistralą PCIe nie jest intensywna. Dlatego wpływ pracy w trybie x8/x8 okazuje się zaskakująco mały.
| Konfiguracja PCIe | Przepustowość na kartę | Wpływ na wydajność AI |
|---|---|---|
| PCIe 5.0 x16/x16 | 100% | Punkt odniesienia |
| PCIe 5.0 x8/x8 | 50% | 0-5% straty wydajności |
| PCIe 4.0 x8/x8 | 25% | 10-15% straty wydajności |
W praktyce platforma AM5 z Ryzen 9 9950X oraz dwoma RTX 6000 Pro Blackwell może osiągać wydajność bardzo zbliżoną do znacznie droższych stacji roboczych opartych na Threadripperze.
Platformma AMD sTR5 i pełne PCIe x16/x16
Platforma Threadripper została zaprojektowana z myślą o profesjonalnych zastosowaniach wymagających dużej liczby linii PCIe oraz bardzo dużej ilości pamięci RAM. Procesory Threadripper i Threadripper PRO oferują wielokrotnie większą liczbę linii PCIe niż klasyczne procesory Ryzen, co pozwala na pracę wielu kart graficznych z pełną przepustowością. Dwie karty RTX 6000 Pro Blackwell mogą pracować w konfiguracji x16/x16 bez żadnych kompromisów. Dodatkowo pozostaje miejsce na szybkie dyski NVMe, karty sieciowe 100 GbE, kontrolery RAID czy dodatkowe akceleratory. Platforma Threadripper zapewnia również znacznie większą elastyczność w przyszłości. Możliwe jest zastosowanie trzech lub czterech GPU, instalacja setek gigabajtów pamięci RAM oraz budowa bardzo wydajnych lokalnych serwerów AI.
Jakich różnic wydajności można się spodziewać?
W zastosowaniach związanych z inferencją różnice pomiędzy AM5 a Threadripperem okazują się zaskakująco niewielkie. Większość modeli językowych działa niemal identycznie niezależnie od tego, czy GPU pracują w trybie x8 czy x16.
Inferencja modeli LLM
Podczas generowania odpowiedzi głównym ograniczeniem jest wydajność samych GPU, a nie magistrala PCIe. Dla większości użytkowników różnice na poziomie kilku procent są praktycznie niezauważalne.
| Model | AM5 PCIe 5.0 x8/x8 | AMD sTR5 PCIe 5.0 x16/x16 |
|---|---|---|
| Llama 4 | 98% | 100% |
| DeepSeek R1 | 97% | 100% |
| Qwen3 | 99% | 100% |
| Mistral Large | 98% | 100% |
Fine-tuning i trenowanie modeli
Podczas trenowania modeli komunikacja pomiędzy GPU staje się znacznie bardziej intensywna. Wymiana gradientów oraz synchronizacja parametrów powodują większe obciążenie magistrali PCIe. Im większy model i im częściej dane muszą być wymieniane pomiędzy kartami, tym wyraźniejsza staje się przewaga platformy Threadripper.
| Scenariusz | AM5 x8/x8 | AMD sTR5 x16/x16 |
|---|---|---|
| LoRA Training | 94-97% | 100% |
| Fine-tuning Llama | 90-95% | 100% |
| Distributed Training | 85-92% | 100% |
Porównanie kosztów konfiguracji x8/x8 vs x16/x16
Przykładowe porównanie kosztów konfiguracji AI opartej o dwie karty graficzne RTX 6000 Pro Blackwell 96 GB pokazuje bardzo wyraźnie, jak dominującą rolę w budżecie odgrywają same GPU, a jak relatywnie niewielki udział mają pozostałe komponenty platformy. W wariancie opartym o AM5 i pracę kart w trybie PCIe x8/x8 całkowity koszt zestawu wynosi około 129 000 zł, natomiast konfiguracja oparta o platformę TRX50 z pełnym trybem PCIe x16/x16 sięga około 155 000 zł. Różnica około 26 000 zł wynika przede wszystkim z wyższej ceny platformy klasy workstation, obejmującej procesor Threadripper, płytę główną TRX50 oraz pamięć ECC, podczas gdy same karty graficzne pozostają identyczne i stanowią zdecydowanie największą część całkowitego kosztu systemu.
| Komponent | AM5 (x8/x8) | TRX50 (x16/x16) |
|---|---|---|
| Procesor | AMD Ryzen 9950X | AMD Threadripper 9960X |
| Płyta główna | ASUS X870E ProArt | ASUS Pro WS TRX50-SAGE |
| Karty graficzne | 2x RTX 6000 Pro 96 GB Max-Q | 2x RTX 6000 Pro 96 GB Max-Q |
| Pamięć RAM | 128 DDR5 (non-ECC) | 128 GB DDR5 ECC RDIMM |
| Chłodzenie CPU | EK-Nucleus CR360 | SilverStone XE360-TR5 |
| Zasilacz | 1600W Platinum | 1600W Platinum |
| Dysk SSD | 2TB M.2 Gen4 | 2TB M.2 Gen4 |
| Obudowa | Fractal North XL | Phanteks Enthoo Pro 2 |
| Cena | ~ 129 000 zł | ~ 153 000 zł |
Dopłata do platformy sTR5 wyłącznie po to, aby uzyskać tryb pracy dwóch kart graficznych w PCIe x16/x16, w wielu scenariuszach nie ma uzasadnienia ekonomicznego ani praktycznego. W zastosowaniach związanych z inferencją modeli AI różnice wydajności pomiędzy x8/x8 a x16/x16 są zwykle niewielkie, dlatego sama wyższa przepustowość magistrali nie rekompensuje istotnie wyższych kosztów całej platformy.
Znacznie bardziej sensownym podejściem do sTR5 jest traktowanie tej platformy jako bazy pod rozbudowę infrastruktury AI, a nie tylko jako sposób na „odblokowanie” pełnego x16 dla dwóch kart graficznych. Kluczową wartością sTR5 staje się możliwość instalacji znacznie większej ilości pamięci DDR5 ECC, co w praktyce ma dużo większy wpływ na stabilność i skalowalność środowiska niż sama różnica w przepustowości PCIe. Dodatkowo płyty główne klasy workstation, oferują nawet do 8 slotów na pamięć RAM, co pozwala na stopniową rozbudowę systemu do bardzo dużych pojemności w zależności od potrzeb projektów AI. W połączeniu z większą liczbą linii PCIe platforma ta daje również realną możliwość dalszej rozbudowy o kolejne karty graficzne w przyszłości, co w praktyce ma znacznie większą wartość niż sama różnica między x8 a x16 przy dwóch GPU. W takim scenariuszu kluczowe staje się jednak odpowiednie zaplanowanie całego systemu zasilania. Przy rozbudowie do trzech lub czterech kart graficznych niezbędny jest znacznie mocniejszy zasilacz, ponieważ to właśnie stabilne zasilanie staje się jednym z głównych czynników ograniczających w tego typu konfiguracjach.
Przykładowa konfiguracja x16/x16 pod dalszą rozbudowę
| Komponent | Specyfikacja |
|---|---|
| Procesor | AMD Ryzen Threadripper PRO 9965WX |
| Płyta główna | Asus PRO WS WRX90E-SAGE SE |
| Pamięć RAM | 2x64 GB DDR5 ECC |
| Karty graficzne | 2x RTX PRO 6000 Blackwell Max-Q 96 GB |
| Dyski | 2x Samsung SSD 990 PRO 2 TB M.2 PCIe NVMe Gen4 (RAID1) |
| Chłodzenie CPU | SilverStone SST-XE360-TR5 |
| Zasilacz | FSP Cannon Pro 2500 W ATX 3.1 PCIe 5.1 Platinum |
| Obudowa | Corsair 9000D |
| Cena | ~ 163 000 zł |
Przy dopłacie rzędu około 10 000 zł do platformy sTR5 w porównaniu do wcześniej przedstawionej opcji na AMD Ryzen Threadripper 9960xX , zyskujemy przede wszystkim nie tyle „więcej wydajności tu i teraz”, co fundamentalnie inną klasę skalowalności całej stacji roboczej AI. W kontekście systemu, który ma pracować z dwiema kartami graficznymi RTX 6000 Pro Blackwell Max-Q 96 GB, taka różnica kosztu jest relatywnie niewielka, a jednocześnie otwiera dostęp do infrastruktury, której nie da się uzyskać na platformach klasy desktop.
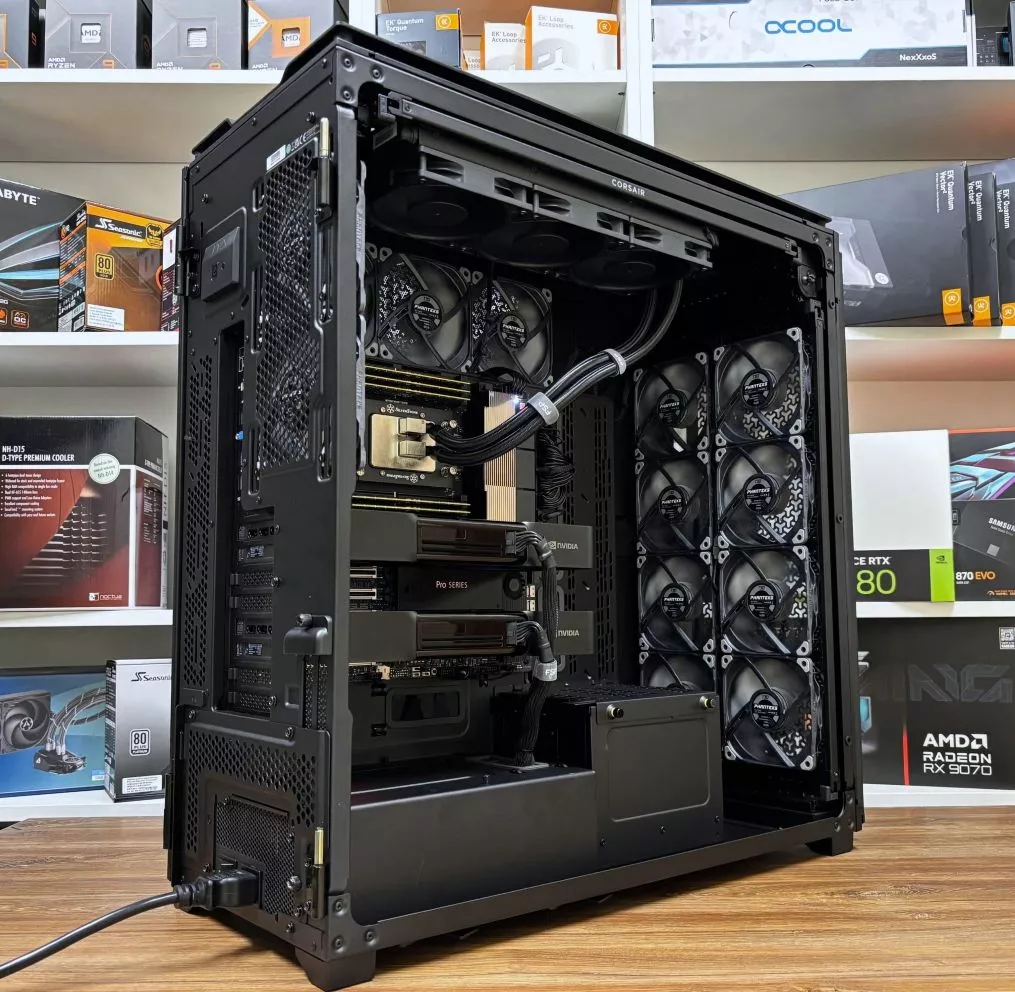
Najważniejszą korzyścią jest możliwość rozbudowy pamięci operacyjnej do poziomu klasy serwerowej. Cztery kanały pamięci i aż 8 slotów DDR5 ECC pozwalają w praktyce osiągnąć nawet 2 TB RAM, co ma ogromne znaczenie w pracy z dużymi modelami językowymi, datasetami oraz środowiskami wielousługowymi.
Drugim kluczowym elementem jest infrastruktura PCIe. Asus PRO WS WRX90E-SAGE SE oferuje 6 fizycznych slotów PCIe 5.0 x16, co w praktyce oznacza możliwość budowy systemu z czterema pełnowymiarowymi kartami graficznymi klasy RTX 6000 Pro Blackwell Max-Q na chłodzeniach fabrycznych albo z 6 sztukami w systemie chłodzenia custom loop z blokami wodnymi 1-slotowymi (przy odpowiednio dobranym mocniejszym zasilaczu). To już nie jest typowa stacja robocza, ale pełnoprawna baza pod lokalny klaster AI, który może obsługiwać równoległe modele, fine-tuning oraz wieloużytkownikowe środowiska inferencyjne.
Trzeci aspekt to elastyczność w zakresie CPU. Platforma TR5 pozwala na dalszą rozbudowę o procesory z jeszcze większą liczbą rdzeni i wątków, co staje się istotne w scenariuszach, gdzie obok GPU intensywnie wykorzystywany jest również CPU - na przykład przy przetwarzaniu danych, tokenizacji, pipeline’ach ETL czy obsłudze wielu procesów AI jednocześnie.
W praktyce oznacza to, że dopłata około 10 000 zł nie kupuje jedynie „lepszej płyty głównej”, ale przede wszystkim przestrzeń do skalowania całego środowiska AI w przyszłości. W momencie, gdy wymagania rosną, zamiast wymieniać całą platformę, można ją stopniowo rozbudowywać o kolejne zasoby - pamięć RAM, kolejne karty graficzne oraz mocniejsze procesory - bez konieczności przebudowy całego systemu od podstaw.
Czy procesor ma znaczenie?
Wbrew obiegowym opiniom procesor nie jest najważniejszym elementem komputera do AI. Nawet Ryzen 9 9950X dysponuje wystarczającą mocą obliczeniową, aby obsłużyć dwie karty RTX 6000 Pro Blackwell. Threadripper zapewnia przewagę przede wszystkim dzięki ogromnej liczbie linii PCIe i możliwości instalacji znacznie większej ilości pamięci RAM. Jego dodatkowe rdzenie są szczególnie przydatne podczas przygotowywania danych, kompresji zbiorów treningowych, przetwarzania multimodalnego oraz zadań wykorzystujących CPU.
Pamięć RAM również ma ogromne znaczenie
Współczesne modele AI potrafią zużywać ogromne ilości pamięci operacyjnej. Dotyczy to szczególnie fine-tuningu, dużych kontekstów oraz środowisk obsługujących wielu użytkowników jednocześnie. Platforma AM5 (płyty główne) pozwala obecnie na instalację do 192 GB pamięci DDR5, co dla większości zastosowań jest całkowicie wystarczające, ale jak wiemy kontrolery pamięci w procesorach AM5 mają ogromny problem z obsługą 4 wysoko taktowanych modułów DDR5, nawet często z listy QVL producenta płyty głównej. Nie zalecamy stosowania 4 modułów na platformie AM5, więc zostaje ograniczenie do 2x48GB lub 2x64GB. Threadripper umożliwia jednak instalację znacznie większej ilości pamięci RAM. W przypadku ogromnych modeli lub rozbudowanych środowisk produkcyjnych taka przewaga może okazać się kluczowa. W zasadzie to jest największa zaleta platformy sTR5 nad AM5 w przypadku dwóch kart graficznych.
Kiedy wybrać AM5 i obsługę kart w x8/x8?
Platforma AM5 z Ryzenem 9 i dwiema kartami RTX 6000 Pro Blackwell jest doskonałym rozwiązaniem dla firm zajmujących się inferencją, generowaniem treści, analizą dokumentów, obsługą agentów AI oraz większością zastosowań biznesowych. Jej największą zaletą jest znakomity stosunek ceny do wydajności. W wielu przypadkach użytkownik otrzymuje ponad 95% wydajności Threadrippera przy zauważalnie niższych kosztach całej platformy. Problemem może być jednak ilość obsługiwanej pamięci DDR5 UDIMM.
Kiedy warto wybrać AMD sTR5 i pełne x16/x16?
Threadripper zaczyna pokazywać swoją przewagę wtedy, gdy celem jest budowa stacji roboczej klasy enterprise. Dotyczy to przede wszystkim trenowania dużych modeli, rozbudowy do trzech lub czterech GPU, instalacji setek gigabajtów pamięci RAM oraz środowisk pracujących przez całą dobę. W takich zastosowaniach większa liczba linii PCIe, wyższa przepustowość i większa skalowalność stają się bardzo istotne.
Sprawdź również
Stacje robocze do AI - Deep Learning i Machine Learning
Komputer do AI lokalnie. Wybierz wydajną stację roboczą dopasowaną do Twoich potrzeb
AI lokalnie vs chmura - co wybrać do pracy z AI?
Ile VRAM potrzebujesz do lokalnego AI?
RTX 5090 vs RTX PRO Blackwell - które GPU wybrać do AI?
Jaki PC do uruchamiania Llama 3 i Mistral?
Komputer do Stable Diffusion - wymagania i polecane zestawy
Jaka karta graficzna do Stable Diffusion? Kompletny poradnik 2026
Karty graficzne NVIDIA RTX PRO Blackwell
Komputery do grafiki 2D, 3D, wideo i AI | ZENPC z NVIDIA Studio
Podsumowanie
Choć intuicyjnie można zakładać, że platforma Threadripper będzie bezdyskusyjnie szybsza, rzeczywistość wygląda inaczej. Dla ogromnej części zastosowań AI platforma AM5 z Ryzenem 9 i dwoma kartami RTX 6000 Pro Blackwell 96 GB pracującymi w trybie PCIe 5.0 x8/x8 oferuje wydajność zbliżoną do Threadrippera x16/x16. Threadripper pozostaje rozwiązaniem bezkompromisowym i najlepszym wyborem dla najbardziej wymagających środowisk, ale w przypadku większości zastosowań związanych z inferencją i codzienną pracą z dużymi modelami językowymi platforma AM5 zapewnia znakomity stosunek ceny do osiąganej wydajności, pozostając jednocześnie jedną z najciekawszych konfiguracji dla profesjonalnych stacji roboczych AI.
FAQ - najczęściej zadawane pytania
Czy PCIe x8 ogranicza wydajność kart graficznych w zastosowaniach AI?
W większości zastosowań związanych z AI wpływ magistrali PCIe x8 na wydajność jest znacznie mniejszy, niż mogłoby się wydawać. Po załadowaniu modelu do pamięci VRAM zdecydowana większość obliczeń wykonywana jest lokalnie przez karty graficzne. Oznacza to, że podczas inferencji modeli językowych różnice pomiędzy konfiguracją PCIe 5.0 x8/x8 a x16/x16 zwykle nie przekraczają kilku procent. Większe znaczenie przepustowość magistrali zaczyna mieć podczas trenowania modeli lub intensywnej wymiany danych pomiędzy kartami.
Czy dwie karty graficzne zawsze oznaczają dwukrotnie wyższą wydajność?
Nie. Skalowanie wydajności zależy od konkretnego zastosowania oraz możliwości wykorzystywanego oprogramowania. Niektóre zadania bardzo dobrze wykorzystują wiele kart graficznych, podczas gdy w innych przyrost wydajności jest znacznie mniejszy. W przypadku trenowania modeli czy obsługi wielu użytkowników jednocześnie korzyści mogą być bardzo duże, jednak przy pojedynczych zapytaniach do modelu wzrost wydajności nie zawsze będzie proporcjonalny.
Czy do AI lepiej wybrać jedną bardzo wydajną kartę graficzną czy dwie karty graficzne?
Wiele zależy od planowanych zastosowań. Jedna karta z dużą ilością pamięci VRAM jest często najlepszym rozwiązaniem dla osób korzystających głównie z inferencji modeli językowych lub generowania obrazów. Dwie karty graficzne zaczynają mieć przewagę wtedy, gdy potrzebna jest większa ilość pamięci, szybsze trenowanie modeli lub możliwość równoległej obsługi wielu zadań.
Czy pamięć VRAM z dwóch kart graficznych sumuje się?
Każda karta graficzna posiada własną pamięć VRAM i system nie widzi jej jako jednej wspólnej przestrzeni. Odpowiednio przygotowane frameworki AI mogą jednak podzielić model pomiędzy dwie karty graficzne i wykorzystać łączną ilość dostępnej pamięci. Dzięki temu możliwe jest uruchamianie modeli, które nie zmieściłyby się na pojedynczej karcie.
Czy dwie karty RTX 6000 Pro Blackwell 96 GB pozwalają uruchamiać większe modele AI?
Tak. Łączna ilość dostępnej pamięci wynosząca 192 GB pozwala pracować z bardzo dużymi modelami językowymi, które nie mieszczą się na pojedynczej karcie. Jest to szczególnie istotne przy modelach klasy 70B i większych oraz podczas pracy z bardzo długim kontekstem.
Czy do dwóch kart graficznych konieczna jest platforma Threadripper?
Nie. Platforma AM5 również pozwala na instalację dwóch kart graficznych. W takim przypadku najczęściej pracują one w trybie PCIe 5.0 x8/x8. Dla większości zastosowań związanych z inferencją modeli AI różnice względem konfiguracji x16/x16 są niewielkie. Threadripper pokazuje swoją przewagę głównie w bardziej wymagających zadaniach i przy dalszej rozbudowie stacji roboczej.
Jak duża jest różnica pomiędzy PCIe 5.0 x8 a PCIe 5.0 x16?
W zastosowaniach związanych z dużymi modelami językowymi różnice są zwykle bardzo małe. W większości przypadków konfiguracja x8/x8 osiąga od 95 do 99% wydajności konfiguracji x16/x16. Ograniczenia zaczynają być bardziej widoczne podczas trenowania modeli oraz przy bardzo intensywnej komunikacji pomiędzy kartami graficznymi.
Czy procesor wpływa na wydajność dwóch kart graficznych?
Procesor ma znaczenie, ale w większości zastosowań AI nie jest najważniejszym elementem komputera. O wiele większy wpływ mają same karty graficzne oraz ilość dostępnej pamięci VRAM. Nowoczesne procesory AMD Ryzen oferują wystarczającą wydajność nawet dla bardzo mocnych konfiguracji wyposażonych w dwie profesjonalne karty graficzne.
Czy Threadripper jest szybszy od Ryzena w zastosowaniach AI?
W przypadku inferencji modeli językowych różnice są często niewielkie. Threadripper zyskuje przewagę przede wszystkim dzięki większej liczbie linii PCIe, możliwości obsługi ogromnej ilości pamięci RAM oraz lepszej skalowalności przy bardziej rozbudowanych konfiguracjach. W zadaniach związanych z trenowaniem dużych modeli przewaga platformy HEDT jest bardziej zauważalna.
Czy Llama i DeepSeek można uruchomić na dwóch kartach graficznych?
Tak. Wiele frameworków AI umożliwia podział modelu pomiędzy dwie karty graficzne. Dzięki temu można korzystać z większej ilości pamięci VRAM i uruchamiać znacznie większe modele niż byłoby to możliwe na pojedynczej karcie.
Czy dwie karty graficzne przyspieszają generowanie odpowiedzi przez model?
W zależności od modelu i wykorzystywanego oprogramowania wzrost wydajności może być różny. Przy pojedynczych zapytaniach nie zawsze występuje liniowy wzrost szybkości generowania odpowiedzi. Znacznie większe korzyści pojawiają się przy obsłudze wielu użytkowników jednocześnie lub podczas równoległego wykonywania wielu zadań.
Czy dwie karty graficzne wymagają specjalnego chłodzenia?
Tak. Profesjonalne akceleratory pracujące pod dużym obciążeniem generują bardzo dużo ciepła. Dlatego odpowiednia obudowa, wydajna wentylacja i zachowanie odpowiednich odstępów pomiędzy kartami są niezwykle ważne dla stabilności całego systemu. W przypadku stacji roboczych pracujących przez wiele godzin dziennie chłodzenie ma ogromny wpływ na niezawodność.
Czy dwie karty graficzne zużywają znacznie więcej energii?
Tak. Wysokowydajne akceleratory AI mogą pobierać bardzo dużą moc, dlatego konfiguracje wyposażone w dwie profesjonalne karty graficzne wymagają wydajnych zasilaczy oraz odpowiedniego chłodzenia. Całkowity pobór energii zależy od konkretnego modelu kart oraz charakteru wykonywanych obliczeń.
Czy dwie karty graficzne są opłacalne do lokalnego AI?
Dla profesjonalnych zastosowań odpowiedź brzmi zdecydowanie tak. Większa ilość pamięci VRAM i wyższa moc obliczeniowa pozwalają pracować z większymi modelami oraz skracają czas trenowania. W przypadku użytkowników korzystających głównie z pojedynczych modeli językowych bardziej opłacalnym rozwiązaniem może być jedna bardzo wydajna karta graficzna.
Czy warto od razu budować komputer przygotowany pod dwie karty graficzne?
Tak, ponieważ wymagania modeli AI rosną z roku na rok. Wybór odpowiedniej płyty głównej, mocnego zasilacza i przestronnej obudowy pozwala w przyszłości łatwo rozbudować komputer bez konieczności wymiany całej platformy. Jest to szczególnie ważne w zastosowaniach profesjonalnych, gdzie inwestycja w sprzęt planowana jest na wiele lat.